鉄道と自動車の2択から、バスを加えた3択へ進んでみましょう。多項ロジットモデル(MNL)でも、基本の順序は「各交通手段の効用→選択確率→対数尤度→係数の推定」です。今回はその構造がコードから見えるように、関数を分けて実装します。
前提は2択ロジットモデルのPython実践です。本記事の900件は新しく作成した架空データで、前記事の600件とは異なります。実在の調査データではありません。
1.ダウンロードしてそのまま実行する
サンプルデータ・実行用ファイルをダウンロード(ZIP)。解凍してから使ってください。独自に作成した架空データと教材コードは、利用・改変・再配布できます。
python -m pip install -r requirements.txt
python run_mnl.py
mode_choice_3.csvは同梱済みです。生成し直したい場合だけmake_sample.pyを実行します。確認環境はPython 3.11.5、NumPy 1.24.3、pandas 2.0.3、SciPy 1.11.1。推定結果estimates.csv、予測確率predictions.csv、評価指標results.jsonを出力・上書きします。
| 列 | 意味 |
|---|---|
| choice | 自動車0・鉄道1・バス2 |
| car/rail/bus_time_min | 各手段の所要時間(分) |
| car/rail/bus_cost_yen | 各手段の費用(円) |
| avail_car/rail/bus | 利用可能1・利用不可0 |
| split | 学習train675件・評価test225件 |
選ばなかった手段の時間と費用も用意する点が重要です。交通手段ごとの条件の違いを比較するモデルなので、実際に利用した手段の情報だけでは足りません。今回の教材では、利用不可の手段についても数値列に有限の非負値を入れ、利用可能性の列で除外します。
2.3本の効用関数と基準の定数項
V_car  = 0        + beta_time * car_time_min  + beta_cost * car_cost_yen / 100
V_rail = ASC_rail + beta_time * rail_time_min + beta_cost * rail_cost_yen / 100
V_bus  = ASC_bus  + beta_time * bus_time_min  + beta_cost * bus_cost_yen / 100
推定するのは鉄道定数・バス定数・共通の時間係数・共通の費用係数の4個です。すべての効用に同じ定数を足しても確率は変わらないため、自動車の定数項を0に固定します。鉄道・バスの定数は自動車との相対値であり、それだけで交通手段の一般的な魅力度を決める値ではありません。
3.利用できない交通手段を分母から除く
P(i)=exp(V_i)/Σ_j exp(V_j)が基本形ですが、分母に含めるのはその人が利用できる手段だけです。コードでは利用不可の効用を−∞に置き換え、exp(−∞)=0になることを使います。全手段が利用不可なら定義できないため、データ検査で止めます。
def log_probabilities(theta, d):
    available = d[["avail_car", "avail_rail", "avail_bus"]].to_numpy(bool)
    V = np.where(available, utilities(theta, d), -np.inf)
    return V - logsumexp(V, axis=1, keepdims=True)
例えば免許や自動車を使えない人を自動車の利用不可として表せます。ただし現実の選択肢集合をどう定義するかは調査設計上の判断です。選んだ手段の利用可能性が0の行は矛盾なので、教材のvalidate関数で検出します。
4.選んだ手段の対数確率を足して推定する
def negative_log_likelihood(theta, d):
    y = d.choice.to_numpy(int)
    log_P = log_probabilities(theta, d)
    return -log_P[np.arange(len(d)), y].sum()

fit = minimize(
    negative_log_likelihood, np.zeros(4), args=(train,),
    jac=gradient, method="BFGS",
    options={"gtol": 1e-6, "maxiter": 1000}
)
選択結果0・1・2を列番号として、各行で実際に選んだ手段の対数確率を取り出します。SciPyは最小化するので、符号を反転した負の対数尤度を渡します。gradientは同じ目的関数の解析的勾配です。全文はZIPのrun_mnl.pyに含めています。収束しない場合に結果をそのまま使わないよう、fit.successも確認しています。
5.推定結果と評価データの予測
| パラメータ | 今回の推定値 |
|---|---|
| 鉄道定数 | 0.464429 |
| バス定数 | −0.206956 |
| 時間1分あたり | −0.060334 |
| 費用100円あたり | −0.207261 |
時間と費用の係数は負で、ほかの条件が同じなら時間・費用が増すほど選ばれにくい結果です。係数の絶対値だけで時間と費用の影響を比較せず、単位をそろえたシナリオ計算などで読みます。今回の記事は推定構造と予測が中心で、標準誤差や有意性の検定は扱っていません。
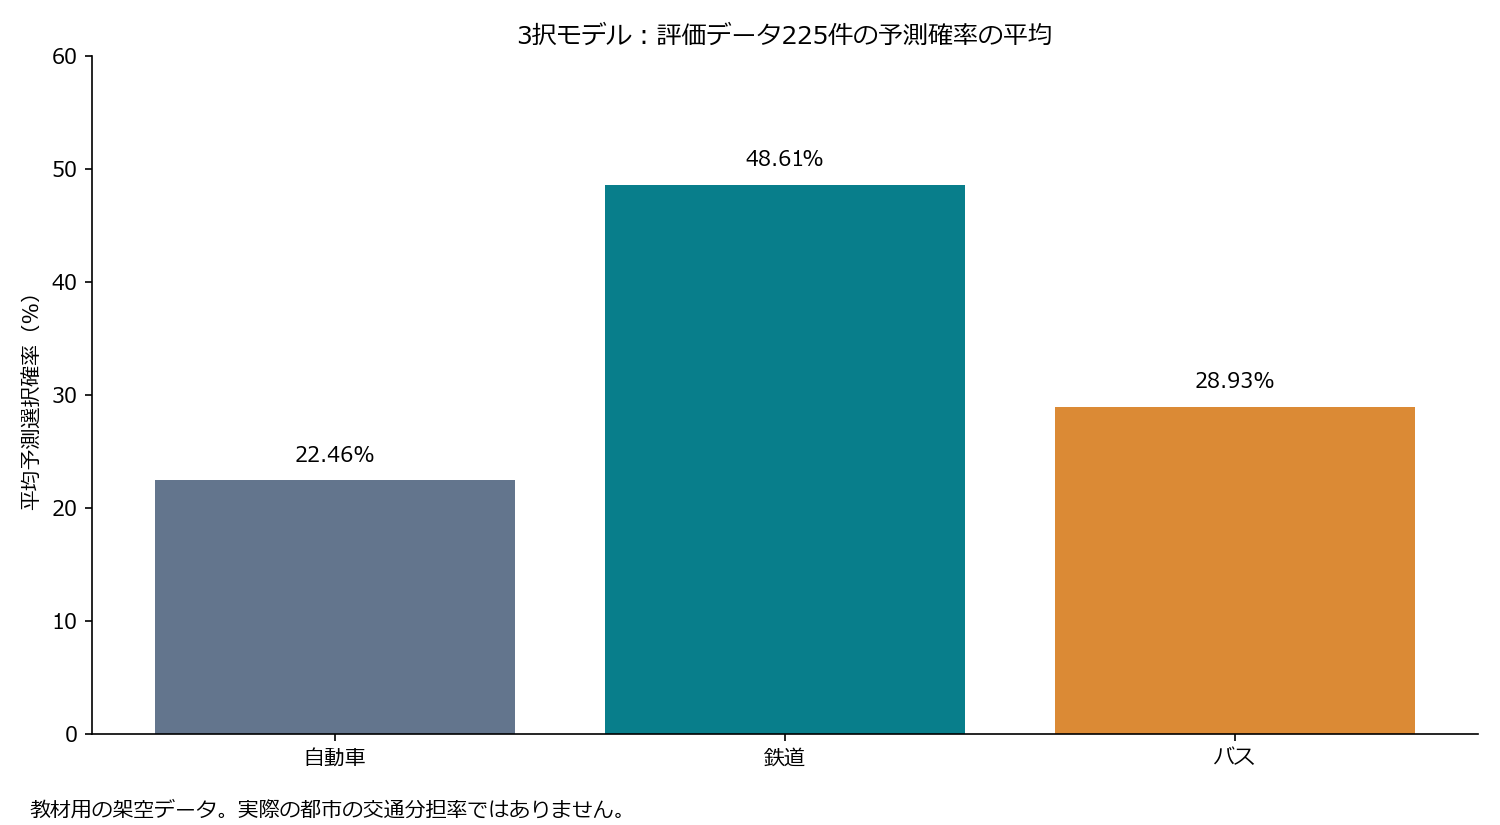
評価データの正解率は約68.44%、対数損失は約0.694655でした。正解率は最大確率の手段が実際の選択と一致した割合、対数損失は実際に選んだ手段にどれほど確率を割り当てたかを見る指標です。確率の平均を描いた上図と、最大確率を選ぶ正解率は異なる集計です。
6.このモデルでできること・残る制約
配布コードでは、各行の3確率の和が1であること、利用不可の手段の確率が0であることを確認しています。作成時には解析勾配と数値差分の一致、および異なる初期値からの係数一致も確認しました。実データでは学習・評価の分離に加え、同じ人の繰り返し回答や拡大係数への対応が別途必要です。
MNLにはIIAという性質があり、2手段の確率比は、共通に利用可能なほかの手段の属性に直接依存しません。鉄道とバスのような似た選択肢に共通する未観測要因が強い場合には、この制約が現実に合わないことがあります。選択肢を増やせば自動的に良いモデルになるわけではなく、ネスティッドロジットや混合ロジットの検討が必要になる場合があります。
参考にした教材と本記事の位置づけ
効用→確率→対数尤度という説明順は、東京大学・羽藤研究室で公開されている「多項ロジットモデル(MNL)の説明」を参考にしました。元資料はRで5交通手段などを扱っています。本記事は3交通手段の独立したPython実装で、元コードの逐語訳や元データの移植ではありません。数値計算のAPIはSciPy公式ドキュメントを参照してください。
コメント