ロジットモデルを推定できたら、「鉄道の運賃を100円下げると、予測はどう変わるか」を試してみましょう。今回はPythonで交通手段選択を推定する前回の記事と同じ600件の架空データと効用関数を使います。係数を固定し、運賃の列だけを変更して比較します。
これはモデルの条件を変えたシナリオ計算です。現実の値下げによる因果効果や実際の交通分担率を示すものではありません。運賃以外の条件や、移動する人の数は変わらないと仮定します。
1.再現用のデータとコードを用意する
サンプルデータ・実行用ファイルをダウンロード(ZIP)。解凍してから使ってください。独自に作成した架空データと教材コードは、利用・改変・再配布できます。
同梱CSVをそのまま使うため、毎回のデータ生成は不要です。mode_choice.csv、run_model.py、run_scenario.py、requirements.txtを同じフォルダに置き、次の2行を実行します。Python 3.11.5、NumPy 1.24.3、pandas 2.0.3、SciPy 1.11.1で確認しました。新しい作業用環境を使うと依存関係を分けられます。
python -m pip install -r requirements.txt
python run_scenario.py
実行するとscenario_results.csvを出力・上書きします。フォルダの場所に関係なく、スクリプト自身の場所からCSVを読む構造です。環境による末尾の桁の違いを考慮し、記事では小数2〜4桁程度を照合してください。
2.効用と確率の構造を確認する
V_rail = ASC_rail + beta_time * rail_time_min + beta_cost * rail_cost_yen / 100
V_car  = 0        + beta_time * car_time_min  + beta_cost * car_cost_yen / 100
P_rail = exp(V_rail) / (exp(V_rail) + exp(V_car))
費用の単位は100円です。自動車の定数項を0にして基準を置きますが、時間と費用を含む自動車の効用全体を0にするわけではありません。実装ではlogsumexpで確率を安定計算します。推定した鉄道定数は0.354609、時間係数は−0.111689、費用係数は−0.303603でした。
3.推定は1回だけ行い、同じ人を比較する
trainの450件だけで係数を推定し、testの150件に対して現状と値下げ後の確率を計算します。条件変更後にモデルを推定し直すことはしません。同じ150件を使うことで、比較中に構成員が変わる影響を避けます。
from pathlib import Path
import numpy as np
import pandas as pd
from scipy.optimize import minimize
from run_model import negative_log_likelihood, gradient, probabilities
ROOT=Path(__file__).resolve().parent
data=pd.read_csv(ROOT/'mode_choice.csv')
train=data.loc[data.split=='train'].copy()
test=data.loc[data.split=='test'].copy()
fit=minimize(negative_log_likelihood,np.zeros(3),args=(train,),jac=gradient,
             method='BFGS',options={'gtol':1e-6,'maxiter':1000})
if not fit.success: raise RuntimeError(fit.message)
rows=[]
baseline=probabilities(fit.x,test)[:,1]
for discount in [0,50,100,200]:
    changed=test.copy()
    changed['rail_cost_yen']=(changed.rail_cost_yen-discount).clip(lower=0)
    predicted=probabilities(fit.x,changed)[:,1]
    assert np.all(predicted >= baseline-1e-12)
    rows.append({'discount_yen':discount,'mean_probability_rail':predicted.mean(),
                 'change_percentage_points':100*(predicted.mean()-baseline.mean())})
result=pd.DataFrame(rows)
result.to_csv(ROOT/'scenario_results.csv',index=False)
print('theta:',fit.x)
print(result.to_string(index=False,float_format=lambda x:f'{x:.6f}'))
changed=test.copy()で元データを残し、鉄道の費用だけを書き換えます。0円未満の運賃にならないようclip(lower=0)を使うため、元の運賃が値下げ額より低い人は0円になります。結果は各人の鉄道選択確率を平均した値で、0.5を超えた人数の割合ではありません。
4.100円の値下げでは何ポイント変わるか
| 値下げ額 | 平均鉄道選択確率 | 現状との差 |
|---|---|---|
| 0円 | 55.19% | 0.00ポイント |
| 50円 | 57.39% | +2.20ポイント |
| 100円 | 59.56% | +4.37ポイント |
| 200円 | 63.83% | +8.64ポイント |
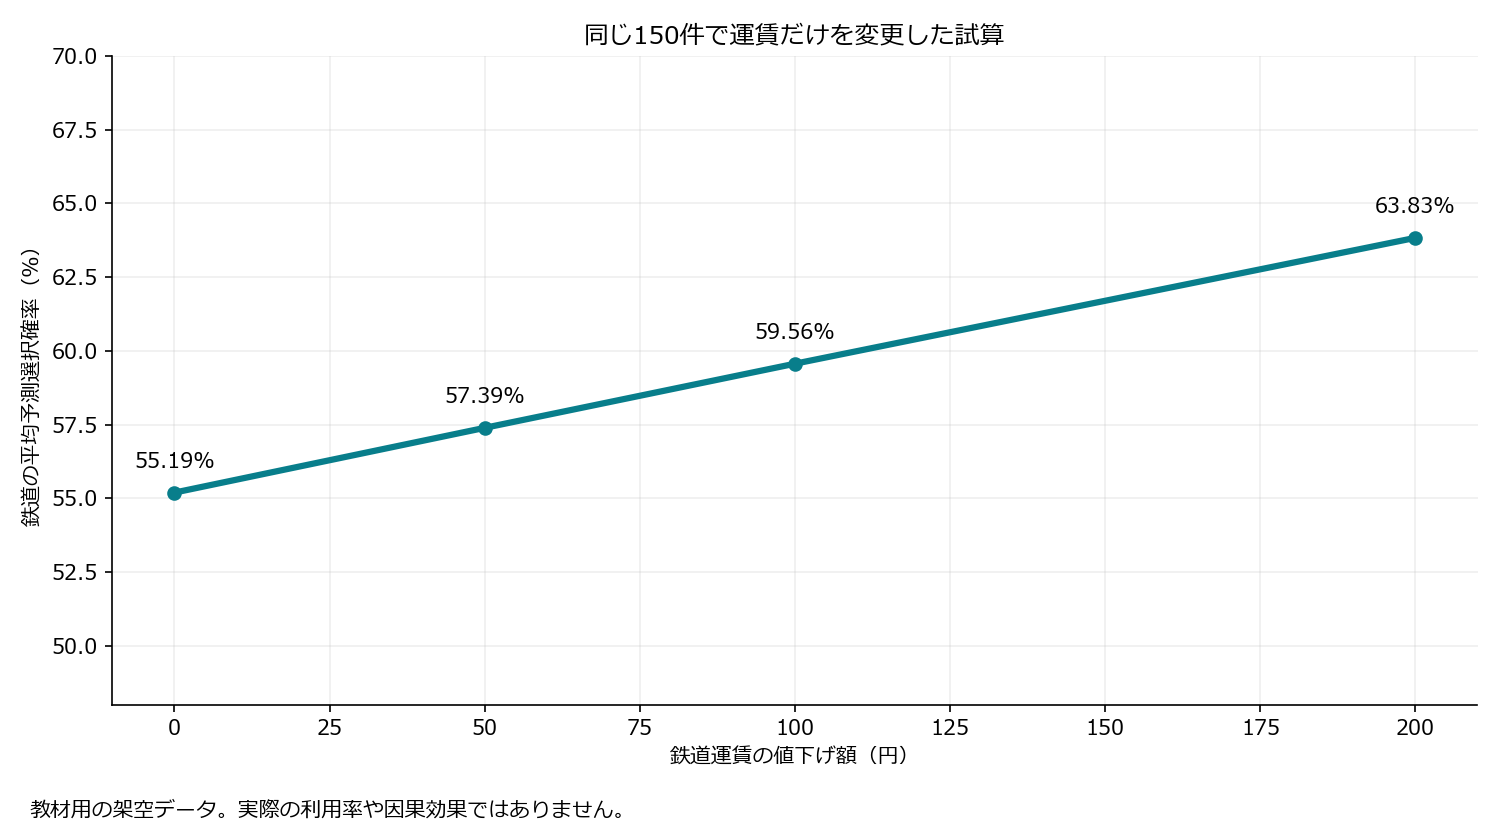
55.19%から59.56%への変化は約4.37「パーセントポイント」です。「4.37%増」とは区別します。また、費用係数の−0.303603を、そのまま確率の変化として読んではいけません。ロジットの確率は非線形なので、同じ100円の差でも元の時間・費用によって変化幅が異なります。
5.交通需要や収入へ広げる前に確認すること
平均確率に対象人数を掛ければ、全員を等しい重みで扱った期待選択人数を計算できます。ただし、この教材の150件は実際の地域を代表する標本ではなく、そのまま地域人口に拡大できません。調査の拡大係数があるなら、各人の確率をその重みで平均する必要があります。
本例は鉄道と自動車の2択で、全員が両方を利用できる前提です。バス、徒歩、移動しない選択、混雑、運行本数の変化は入れていません。値下げに伴ってサービス水準が変わる場合や、未観測の要因と運賃が関係する場合、単純な運賃の書き換えだけで実際の効果は分かりません。係数の推定誤差も今回の表には含めていません。
6.次に試すなら所要時間を変える
同じ構造でrail_time_minを5分短くする試算も可能です。ただし単位を混同しないこと、非現実的な負の時間にしないこと、現状との比較対象を同じにすることが必要です。データ範囲から大きく離れた設定では、推定モデルの外挿になる点にも注意しましょう。
参考資料
確率計算はSciPyのlogsumexp、最適化はminimizeを使用しています。モデルの基礎は都市交通とロジットモデルも参照してください。
コメント