「ロジットモデルの数式は分かったけれど、Pythonではどこに効用関数を書くの?」という方に向けて、鉄道と自動車の2択を例に推定を実践します。今回は効用、選択確率、対数尤度をそれぞれコードで明示し、計算の流れを追える構成にしました。
本記事の600件はすべて教材用に作成した架空データです。データと実行コードを同じZIPで配布するので、ダウンロードして実行し、掲載した数値と照合できます。理論の入り口は都市交通とロジットモデルをご覧ください。
1.サンプルをダウンロードして実行する
サンプルCSV・Pythonコード・結果をまとめてダウンロード(ZIP)。まずはこのZIPを解凍してください。データの中身だけ確認したい場合はサンプルCSV単体も利用できます。教材のコード・架空データは自由に改変・再配布できます。
ZIPにはmode_choice.csv、run_model.py、make_sample.py、requirements.txt、README.md、期待される推定結果などが入っています。CSVは同梱済みなので、通常はデータ生成コードを実行する必要はありません。CSV単体を利用する場合はmode_choice.csvという名前でrun_model.pyと同じフォルダに保存します。
Python 3.11を利用できる作業用環境で、解凍先のフォルダを開き、次の2行を順に実行します。確認環境はPython 3.11.5、NumPy 1.24.3、pandas 2.0.3、SciPy 1.11.1です。requirements.txtでライブラリのバージョンを指定しています。
python -m pip install -r requirements.txt
python run_model.py
実行すると推定結果を表示し、estimates.csv、predictions.csv、results.jsonを同じフォルダへ出力・上書きします。配布済みの結果を比較用に残す場合は別のフォルダにコピーしてください。環境によって末尾の桁が変わることがあるため、係数は小数4桁程度を目安に照合します。
2.データの列と単位を確認する
| 列名 | 意味 |
|---|---|
| rail_time_min / car_time_min | 鉄道/自動車の所要時間(分) |
| rail_cost_yen / car_cost_yen | 鉄道/自動車の費用(円) |
| choose_rail | 選択結果。鉄道=1、自動車=0 |
| split | train=学習450件、test=評価150件 |
| id | 架空の選択レコードを識別するID |
選んだ交通手段だけでなく、選ばなかった交通手段の時間・費用も必要です。今回は全員が両方の交通手段を利用できる設定です。実際のデータでは、利用できない選択肢を確率の分母から除く「利用可能性」の扱いも必要になります。
この教材は時間差・費用差から選択結果を生成し、各手段の効用を読みやすくするために架空の自動車の時間・費用を追加したものです。鉄道の値は自動車の値に差を加えて作っています。実測値ではなく、現実の交通機関の優劣を表すものではありません。学習・評価の区分もCSVに固定しています。
3.交通手段ごとの効用関数を書く
時間と費用が選択にどう影響するかを、まず2本の効用関数に書きます。時間係数と費用係数は両交通手段で共通とし、鉄道に定数項を置きます。以下は配布コードのutilities関数です。
def utilities(theta, data):
    asc_rail, beta_time, beta_cost = theta
    V_rail = (asc_rail
              + beta_time * data["rail_time_min"].to_numpy()
              + beta_cost * data["rail_cost_yen"].to_numpy() / 100)
    V_car = (0.0
             + beta_time * data["car_time_min"].to_numpy()
             + beta_cost * data["car_cost_yen"].to_numpy() / 100)
return np.column_stack([V_car, V_rail]) # column 0=car, 1=rail費用は円の列を100で割り、係数を「100円あたり」として解釈します。時間は分のままです。自動車の定数項だけを0に固定しており、自動車の効用全体を0にしているわけではありません。両方に自由な定数項を置くと、その差しか識別できないためです。
2択で時間・費用の係数が共通なので、効用の差を取ると次の式になります。差を使った二項ロジットと、各手段の効用を明示したこのモデルは同じ内容です。
V_rail - V_car = ASC_rail
    + beta_time * (rail_time_min - car_time_min)
    + beta_cost * (rail_cost_yen - car_cost_yen) / 100
4.効用から選択確率を計算する
鉄道の選択確率はP(鉄道)=exp(V_rail)/[exp(V_car)+exp(V_rail)]です。自動車も同じ分母で計算し、2つの確率の合計は1になります。実装では大きな効用でも計算が不安定になりにくいlogsumexpを使い、まず対数確率を求めます。
def log_probabilities(theta, data):
    V = utilities(theta, data)
    return V - logsumexp(V, axis=1, keepdims=True)


def probabilities(theta, data):
    return np.exp(log_probabilities(theta, data))
戻り値の0列目が自動車、1列目が鉄道です。確率の計算そのものを関数として分けると、係数を変えたときに選択確率がどう変わるかも確かめられます。
5.対数尤度を作り、パラメータを推定する
各レコードで「実際に選んだ交通手段」の対数確率を取り出して合計したものが、対数尤度です。choose_railの0/1と、確率の列順を対応させています。
def log_likelihood(theta, data):
    log_P = log_probabilities(theta, data)
    chosen = data["choose_rail"].to_numpy(dtype=int)
    return log_P[np.arange(len(data)), chosen].sum()


def negative_log_likelihood(theta, data):
    return -log_likelihood(theta, data)
SciPyのminimizeは最小化を行うため、対数尤度にマイナスを付けた関数を渡します。配布コードでは、次のように学習データだけで推定します。以下の抜粋にあるgradientは配布コード内の勾配計算関数です。抜粋を単独で実行するのではなく、最初にZIP内のrun_model.pyを実行してください。
train = data.loc[data["split"] == "train"].copy()
test = data.loc[data["split"] == "test"].copy()
initial = np.zeros(3)
result = minimize(negative_log_likelihood, initial, args=(train,),
                  method="BFGS", jac=gradient,
                  options={"gtol": 1e-6, "maxiter": 1000})
最適化の収束を確認し、収束しなかった場合は配布コードがエラーを出すようにしています。係数が表示されたことだけで判断せず、欠損、変数の単位、完全分離、変数の強い重複なども確認しましょう。同じ人の繰り返し回答や複数年の実測データでは、人単位・時点単位で学習と評価を分ける工夫も必要です。
6.推定結果を数値とグラフで読む
| パラメータ | 推定値(概数) | 解釈 |
|---|---|---|
| ASC_rail | 0.354609 | 時間・費用が同じときの鉄道側の相対的な定数項 |
| beta_time_per_min | −0.111689 | 他の条件が同じなら時間が長い交通手段を選びにくい |
| beta_cost_per_100yen | −0.303603 | 他の条件が同じなら費用が高い交通手段を選びにくい |
時間差・費用差がともに0なら、鉄道を選ぶ予測確率は約58.8%です。時間差だけを+10分、つまり鉄道の方が10分長い設定にすると約31.8%になります。あくまで教材モデルから計算した値で、現実の鉄道利用率ではありません。
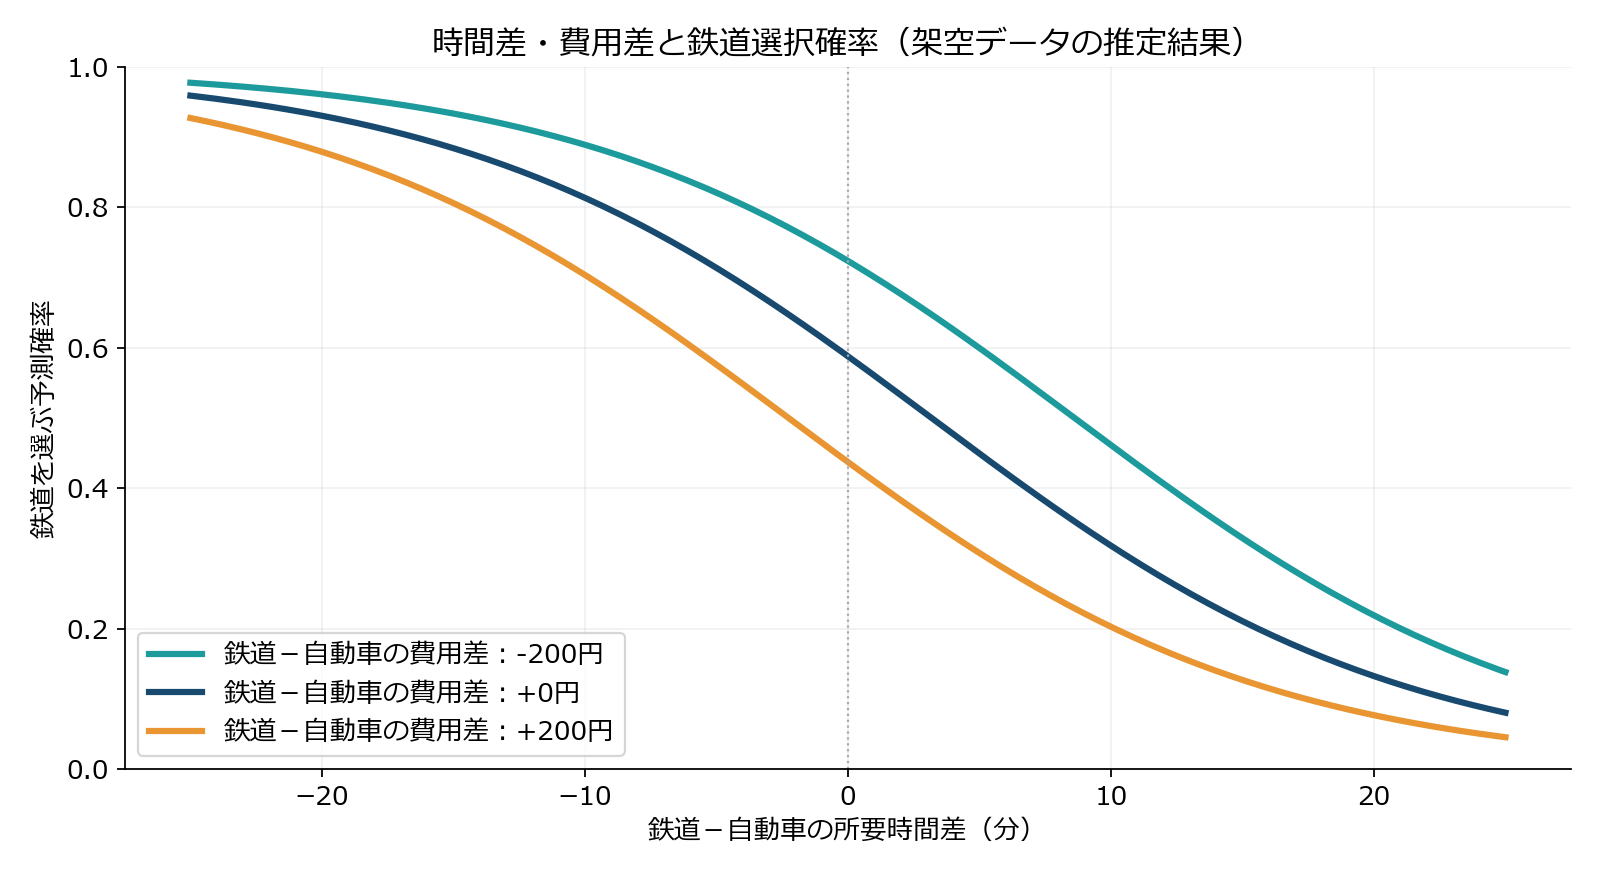
時間差1分のオッズ比はexp(−0.111689)≒0.894です。「確率が10.6ポイント下がる」という意味ではありません。確率の変化量は元の条件によって変わります。時間係数と費用係数は単位が異なるので、絶対値だけで影響の大小を比較しないようにします。
配布コードは標準誤差とz値も出力します。標準誤差はこの二項ロジットの負の対数尤度のヘッセ行列から計算したもので、大標本近似を前提とします。同じ人の複数回答を考慮するクラスタ頑健標準誤差ではありません。
| 学習データ450件の指標 | 値 |
|---|---|
| 全パラメータ0の初期対数尤度 | −311.916231 |
| 推定後の最終対数尤度 | −216.449178 |
| 等確率モデルを基準とするρ² | 0.306066 |
| パラメータ数を考慮した修正済みρ² | 0.296448 |
ここでのρ²は、両選択肢の確率を0.5とする初期モデルに対する指標です。通常の回帰分析の決定係数とは意味が異なります。また、これらは学習データへの当てはまりであり、未知データでの予測性能とは区別します。
7.学習に使っていないデータで検証する
評価用150件で予測確率0.5以上を鉄道と判定します。基準モデルは、学習データで多かった交通手段を全員に返す判定と、学習データの鉄道選択割合を全員に返す確率です。評価データの選択割合を使って基準を調整してはいません。
| 評価指標 | 基準モデル | ロジットモデル |
|---|---|---|
| 正解率 | 61.3% | 77.3% |
| 対数損失 | 0.673559 | 0.494283 |
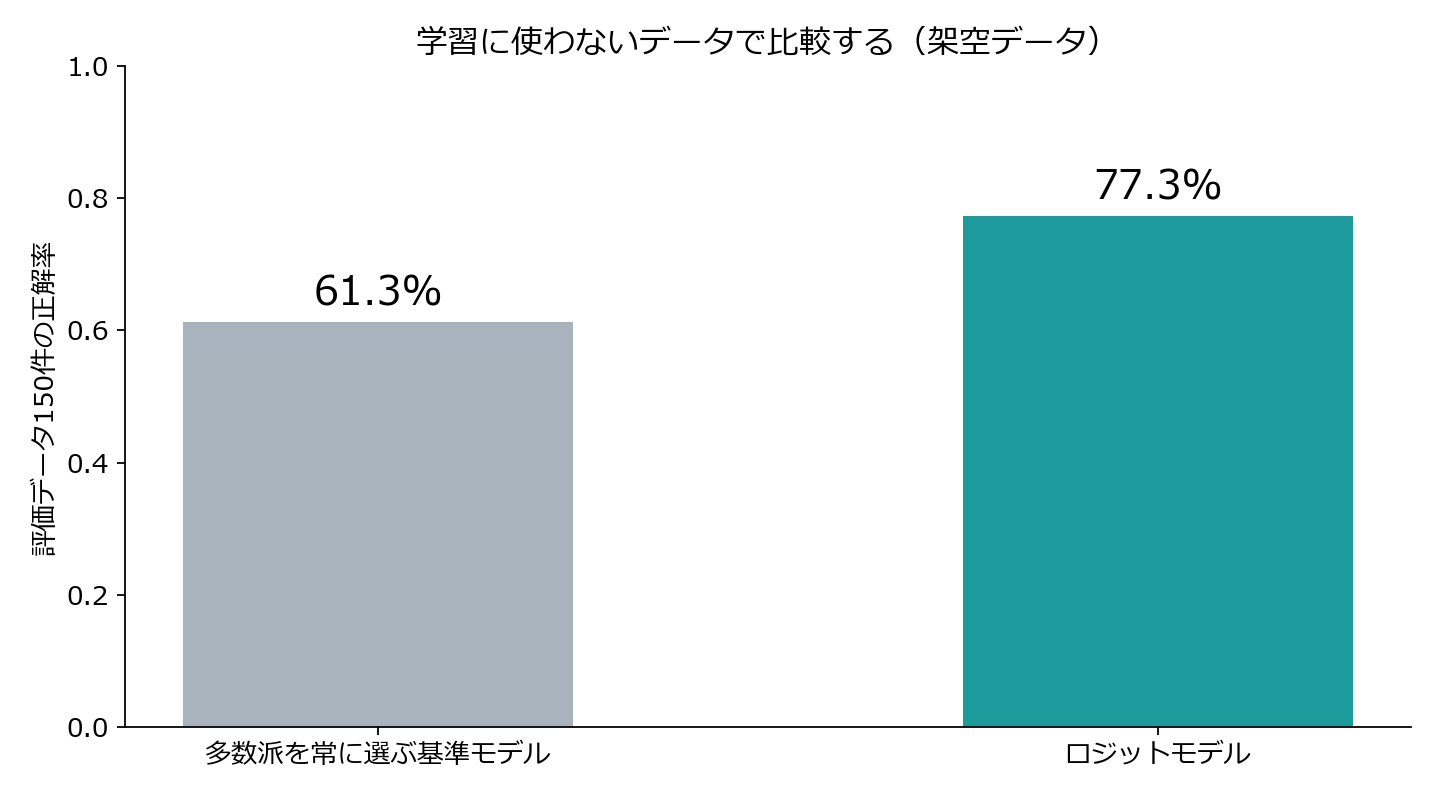
対数損失は、実際の選択にどれだけ適切な確率を与えたかを見る指標で、小さい方が良い値です。配布結果のtest_accuracyとtest_log_lossを照合してください。別実装のstatsmodelsとも係数が絶対誤差1e-7以内で一致することを確認しました。1回の分割だけで性能が確定するわけではなく、実務では交差検証や別時点の評価も検討します。
まとめ・参考資料
今回は「データを見る→効用を書く→確率を作る→尤度を最大化する→未知データで検証する」という流れを実装しました。まずサンプルをそのまま動かし、次に効用関数の時間・費用を変えて、予測確率がどう動くかを確かめてみてください。評価の考え方は交通分野におけるモデルの検証方法でも整理しています。
本記事の説明順序は、東京大学・羽藤研究室の公開教材「多項ロジットモデル(MNL)の説明」を参考にしました。参照先は5交通手段や利用可能性を扱うRの教材です。本記事は2交通手段の独自教材・独立実装であり、元データや元コードを移植したものではありません。
実装資料:SciPy公式:minimize、SciPy公式:logsumexp。3交通手段以上へ拡張する場合は多項ロジットとして効用・選択肢・利用可能性を設計し直します。実際の観察データから政策の因果効果を直ちに断定することもできません。
コメント